AI代理店向けWebデータ:クライアントの回答を最新に保つ
クライアントがサービスを変更したり、製品を発売したり、新しいガイドを公開したとします。そのAIワークフローには新しい情報と、提示できる情報源が必要です。QuanticDataは、MapによるWebサイトの発見、SERPによる構造化されたWeb検索、レポート用のAI引用データをRESTまたはMCP経由でAI代理店に提供します。
月額$2の無料API利用 · カード不要 · 失敗した呼び出しは課金されません
クライアントの問題
「チャットボットがまだ古いオファーを説明している」

Map → 関連ページを検索
選択 → 有用な情報源を保持
読む → 現在のページ内容を取得
保存 → ナレッジベースを更新

クライアントが必要とする作業から始める
チャットボット、調査アシスタント、クライアントレポートにはそれぞれ異なる入力が必要です。今日クライアントが確実に答えられない質問から始め、その回答を可能にするデータステップを選択します。
「チャットボットが古いWebサイトのコンテンツを使っている」
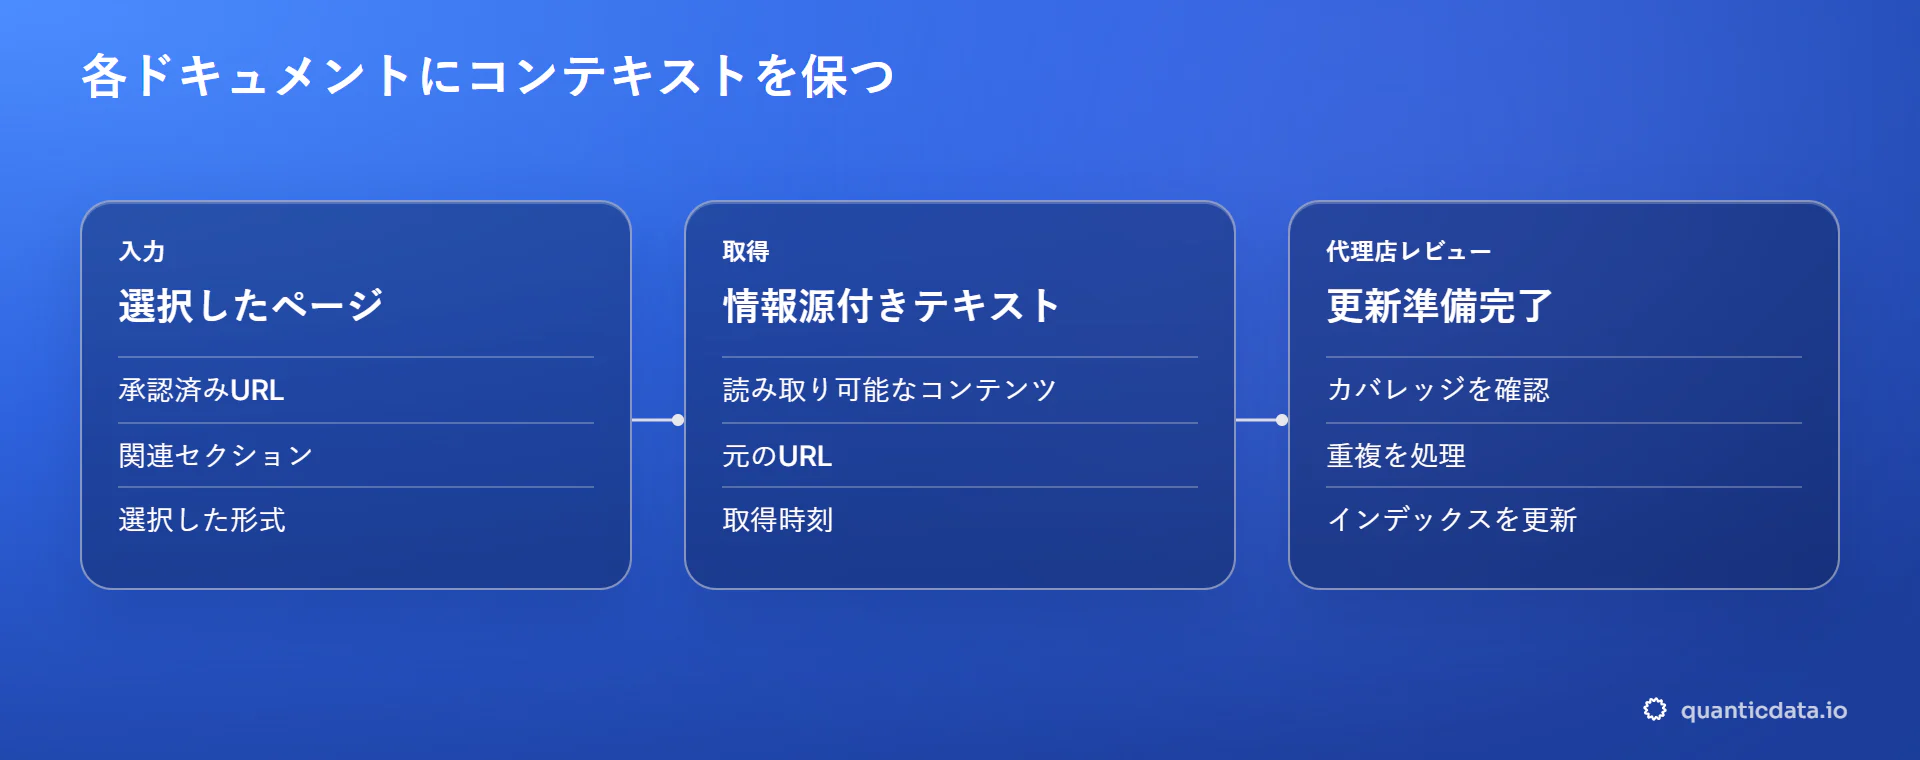
Mapで関連するWebサイトのURLを検索 (EN)します。CrawlまたはBatchでコンテンツを取得する前に、サービスページ、ヘルプ記事、ドキュメントを選択します。各ドキュメントと一緒に情報源URLを保存し、回答が使用したページを指し示せるようにします。
ワークフローは再実行のタイミングを決定し、新しいコンテンツを保存済みバージョンと比較し、インデックスを更新します。これにより、Webサイトの変更は手動の調査セッションではなく、定義されたメンテナンスタスクになります。
「調査アシスタントがファイル以外の情報を必要としている」
クライアントが必要とするクエリ、国、言語でSERPによる構造化Web検索 (EN)を利用します。有用な結果を選択し、そのページを読み、回答と共に証拠を保持します。検索結果は情報源を見つけるのに役立ちます。ページの内容が詳細な主張を支えるものです。
これはサプライヤー調査、企業ブリーフィング、新しいトピックの発見に役立ちます。RESTはアプリケーションコードに適合し、MCPは互換性のあるエージェントがツールを利用できるようにします。
「クライアントはブランドがAI回答のどこに表示されるかを知りたがっている」
AI Visibility API経由のAI Citations (EN)を、再現可能なバイヤー質問セットで使用します。ブランドの言及とクライアントページへのリンクを分離し、各観察に使用したエンジンとモードを記録します。
レポートサービスについては、SEO代理店ワークフローに従います。引用観察はテストした回答を測定するものであり、それ自体がアシスタントが情報源を選んだ理由を説明するものではありません。
ワークフローを構築する前に実際のMap結果を検査する
2026年10月31日に返された6件のドキュメントURL。 quanticdata.ioをフィルタ/docs/と戻り値上限6でマッピングしました。結果にはドキュメントホーム、Python、Node、cURL、PHPのクイックスタート、およびMarkdownドキュメントファイルが含まれていました。
これは発見のサンプルであり、完全なクロールやパフォーマンスベンチマークではありません。取得前にURLを検査してください。HTMLページとそのMarkdown版は同じ情報を表す場合があります。アプリケーションが必要とする表現を保持し、情報源URLを安定した参照として使用します。
クライアントが承認した公開Webサイトで同じプロセスを試してください。含めるセクションを合意し、選択したURLを一緒に確認してからテキストを取得します。大量のURL数を成功とみなすのではなく、クライアントが見つけることを期待するページでカバレッジを確認します。
1つのクライアントソースを再現可能な納品に変える
| クライアント入力 | データステップ | 確認する成果物 |
|---|---|---|
| Webサイトと重要なセクション | Map、次に選択的取得 | URLインベントリと情報源リンク付きドキュメント |
| 質問、市場、言語 | SERP、次に情報源の読み取り | 結果と証拠付きブリーフィング |
| ブランドとバイヤー質問 | AI Citations | 言及と引用URLを含む日付付き観察 |
小さな情報源セットから始め、有用な結果とは何かを定義します。受け入れチェックには、必要なページ、読み取り可能なテキスト、重複処理、証拠へのリンクを含めることができます。入力と取得時刻を保持し、次の実行を比較可能にします。
サンプルが機能したら、データベース、ベクトルストア、レポートシステムに接続します。スケジューリング、インデックス作成、顧客向け納品は、お客様が管理するワークフローに残ります。失敗した取得と有効な空の結果を区別し、収集の問題が静かに回答になってしまわないようにします。
機能を選択し、スタックを接続する
MapはURLを発見する必要がある場合に有用です。Crawlは設定したスコープ内でページを探索して取得します。Batchは既知のURLリストで動作します。SERPはWeb全体から情報源を見つけます。AI CitationsはサポートされているAI回答モードでの情報源と言及を観察します。これらは異なるステップであるため、プロジェクトは必要なものだけを組み合わせることができます。
ここでの例は出発点です。移行インベントリ、サプライヤードキュメント、その他の情報源ベースのワークフローも、入力と要件が適合すれば同じ機能を利用できます。サービスを利用するために特定の業種に一致する必要はありません。
APIリファレンス (EN)を使用して、現在の入力と出力を確認してください。クライアントがサポートされている情報源から構造化データを必要とする場合、コレクターが既に提供しているかもしれません。プロキシの管理は、独自の取得アプリケーションを実行する場合に関係します。これらのData APIから結果を受け取るための前提条件ではありません。
アクセスが許可されている情報源を使用し、該当する利用規約に従ってください。
次のクライアントプロジェクトの背後にある情報源をテスト
1つのWebサイトにはMap、1つの調査質問にはSERP、バイヤー質問パネルにはAI Citationsから始めます。ドキュメント化されたREST呼び出しまたはMCPクライアントを使用します。月額$2の無料API利用。
情報源と標準
現在のAPI契約と、これらのワークフローで使用される発見および取得ステップを確認してください。
Webサイトのチャットボットを最新に保つには?
重要なページを発見し、現在のコンテンツを取得し、情報源URLを保持します。アプリケーションが必要とするスケジュールでこれらのステップを実行し、スナップショットを比較してナレッジベースを更新します。MapはURL発見を処理し、ワークフローはスケジューリング、インデックス作成、チャットボット自体を管理します。
Mapはすべてのページのテキストを返しますか?
MapはWebサイト発見ソースを使用してURLを発見します。Crawl、Batch、またはページ読み取りでコンテンツを取得する前に、ページを検査して選択するために使用します。返されたスコープと制限をプロジェクトと照合してください。URLの発見とコンテンツの読み取りは別の操作です。
既存のAIまたはn8nワークフローに接続できますか?
はい。HTTPステップからドキュメント化されたRESTエンドポイントを使用するか、互換性のあるクライアントをQuanticData MCPサーバーに接続します。認証情報はワークフローの認証情報ストアに保管してください。自動化がスケジュールを提供し、返されたデータを既に使用している宛先に接続します。
クライアントはプロキシを理解する必要がありますか?
いいえ。クライアントが必要とする情報と検証できる出力から始めます。Data APIとコレクターは、サポートされているリクエストの取得ステップを処理します。プロキシは、代理店が既に独自のスクレーパーやアプリケーションを運用していて、ネットワーク接続を管理する必要がある場合に関係します。
これらのワークフローはチャットボットプロジェクトに限定されますか?
いいえ。例は機能を示すものであり、用途の排他的なリストではありません。Webサイトインベントリ、サプライヤー調査、企業ブリーフィング、ドキュメント発見も同じステップを利用できます。必要な情報源、入力、出力がサポートされていることを確認し、クライアントが評価できるサンプルを定義します。