Données web pour agences IA : des réponses clients à jour
Votre client modifie un service, lance un produit ou publie un nouveau guide. Son flux IA a besoin de cette information et d'une source à montrer. QuanticData fournit aux agences IA la découverte de sites avec Map, la recherche web structurée avec SERP et les données de citations IA pour le reporting, via REST ou MCP.
2 $ d'usage API gratuit par mois · Sans carte · Les appels échoués ne sont jamais facturés
Problème du client
« Le chatbot décrit encore notre ancienne offre. »

Map     → trouver les pages pertinentes
Select  → garder les sources utiles
Read    → récupérer le contenu actuel
Store   → mettre à jour votre base de connaissances

Partez du travail que votre client doit accomplir
Un chatbot, un assistant de recherche et un rapport client ont besoin d'entrées différentes. Partez de la question à laquelle le client ne peut pas répondre fiablement aujourd'hui, puis choisissez l'étape de données qui rend la réponse possible.
« Notre chatbot utilise un ancien contenu du site. »
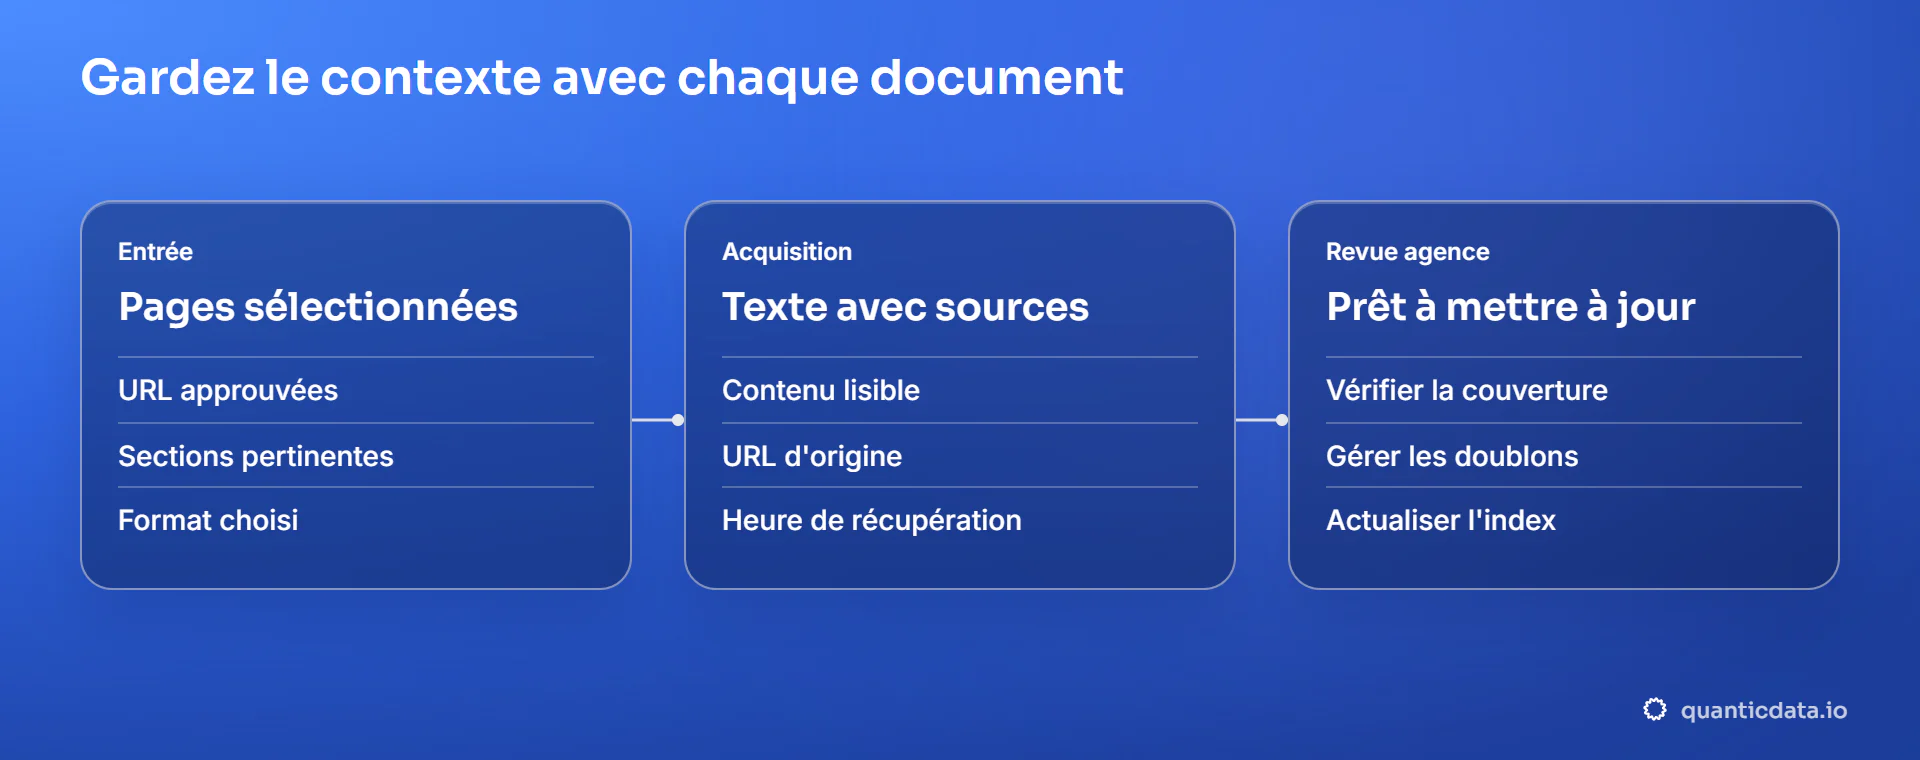
Utilisez Map pour trouver les URL pertinentes du site (EN). Sélectionnez les pages de services, les articles d'aide ou la documentation avant d'acquérir leur contenu avec Crawl ou Batch. Conservez l'URL source avec chaque document pour qu'une réponse puisse renvoyer à la page utilisée.
Votre flux décide quand relancer, compare le nouveau contenu avec la version enregistrée et met à jour son index. Une modification du site devient ainsi une tâche de maintenance définie, et non une nouvelle session de recherche manuelle.
« Notre assistant de recherche a besoin d'informations hors de nos fichiers. »
Utilisez SERP pour une recherche web structurée (EN) avec la requête, le pays et la langue dont votre client a besoin. Sélectionnez les résultats utiles, lisez ces pages et conservez la preuve avec la réponse. Un résultat de recherche aide à trouver une source ; c'est le contenu de la page qui étaye une affirmation détaillée.
Cela fonctionne pour la recherche de fournisseurs, les notes sur les entreprises et la découverte de nouveaux sujets. REST convient au code de votre application ; MCP rend les outils disponibles à un agent compatible.
« Le client veut savoir où sa marque apparaît dans les réponses IA. »
Utilisez AI Citations via l'API AI Visibility (EN) avec un ensemble reproductible de questions d'acheteurs. Distinguez les mentions de marque des liens vers les pages du client, et notez le moteur et le mode utilisés pour chaque observation.
Pour un service de reporting, suivez le flux de l'agence SEO. Les observations de citations mesurent les réponses testées ; elles n'expliquent pas à elles seules pourquoi un assistant a choisi une source.
Inspectez un résultat Map réel avant de construire le flux
6 URL de documentation retournées le 31 octobre 2026. Nous avons cartographié quanticdata.io avec le filtre /docs/ et une limite de six résultats. Le résultat incluait l'accueil de la documentation, les démarrages rapides Python, Node, cURL et PHP, ainsi que le fichier de documentation Markdown.
Il s'agit d'un échantillon de découverte, pas d'un crawl complet ni d'un test de performance. Inspectez les URL avant l'acquisition : une page HTML et sa version Markdown peuvent représenter la même information. Conservez la représentation dont votre application a besoin et utilisez l'URL source comme référence stable.
Essayez la même démarche sur un site public approuvé par le client. Convenez des sections à inclure, vérifiez ensemble les URL sélectionnées puis acquérez le texte. Confirmez la couverture à partir des pages que votre client s'attend à trouver, sans considérer un grand nombre d'URL comme un succès en soi.
Transformez une source client en livraison reproductible
| Entrée client | Étape de données | Livrable à vérifier |
|---|---|---|
| Un site et les sections importantes | Map, puis acquisition sélectionnée | Inventaire d'URL et documents liés aux sources |
| Une question, un marché et une langue | SERP, puis lecture des sources | Résultats et note avec preuves |
| Une marque et des questions d'acheteurs | AI Citations | Observations datées avec mentions et URL citées |
Commencez par un petit ensemble de sources et définissez à quoi ressemble un résultat utile. Votre contrôle d'acceptation peut couvrir les pages requises, la lisibilité du texte, la gestion des doublons et les liens vers les preuves. Conservez l'entrée et l'heure de récupération pour que l'exécution suivante soit comparable.
Quand l'échantillon fonctionne, reliez-le à votre base de données, votre base vectorielle ou votre système de reporting. La planification, l'indexation et la livraison au client restent dans le flux que vous contrôlez. Distinguez une récupération échouée d'un résultat vide valide, pour qu'un problème de collecte ne devienne pas silencieusement une réponse.
Choisissez la capacité, puis connectez votre stack
Map est utile lorsque vous devez découvrir des URL. Crawl explore et acquiert des pages dans le périmètre que vous fixez. Batch travaille avec une liste d'URL connues. SERP trouve des sources sur le web. AI Citations observe les sources et les mentions dans les modes de réponse IA pris en charge. Ce sont des étapes différentes : votre projet peut ne combiner que celles dont il a besoin.
Les exemples ici sont des points de départ. Des inventaires de migration, une documentation fournisseur et d'autres flux basés sur des sources peuvent utiliser les mêmes capacités lorsque leurs entrées et besoins correspondent. Vous n'avez pas besoin de correspondre à un secteur nommé pour utiliser le service.
Consultez la référence API (EN) pour vérifier les entrées et sorties actuelles. Si votre client veut des données structurées d'une source prise en charge, un collecteur peut déjà les fournir. Gérer des proxies est pertinent lorsque vous exploitez votre propre application d'acquisition ; ce n'est pas un prérequis pour recevoir des résultats de ces API de données.
Utilisez des sources que vous êtes autorisé à consulter et respectez leurs conditions applicables.
Testez la source de votre prochain projet client
Commencez par Map pour un site, SERP pour une question de recherche ou AI Citations pour un panel de questions d'acheteurs. Utilisez les appels REST documentés ou votre client MCP. 2 $ d'usage API gratuit par mois.
Sources et normes
Vérifiez les contrats API actuels et les étapes de découverte et d'acquisition utilisées dans ces flux.
FAQ
Réponses pratiques pour relier les sources client au flux IA que vous construisez.
Autre chose ? Contactez-nousComment maintenir à jour le chatbot d'un site web ?
Découvrez les pages importantes, acquérez leur contenu actuel et conservez les URL sources. Exécutez ces étapes selon la fréquence dont votre application a besoin, comparez les instantanés et mettez à jour la base de connaissances. Map gère la découverte d'URL ; votre flux gère la planification, l'indexation et le chatbot lui-même.
Map renvoie-t-il le texte de chaque page ?
Map découvre des URL à partir de sources de découverte de sites. Utilisez-le pour inspecter et sélectionner des pages avant d'acquérir leur contenu avec Crawl, Batch ou une lecture de page. Vérifiez le périmètre et les limites retournés selon votre projet ; découvrir une URL et lire son contenu sont deux opérations distinctes.
Puis-je relier cela à un flux IA ou n8n existant ?
Oui. Utilisez les points de terminaison REST documentés depuis une étape HTTP, ou connectez un client compatible au serveur MCP de QuanticData. Conservez les identifiants dans le coffre d'identifiants de votre flux. Votre automatisation fournit la planification et relie les données retournées à la destination que vous utilisez déjà.
Mes clients doivent-ils comprendre les proxies ?
Non. Partez de l'information dont ils ont besoin et du résultat qu'ils peuvent vérifier. Les API de données et les collecteurs gèrent l'étape d'acquisition pour les requêtes prises en charge. Un proxy devient pertinent lorsque votre agence exploite déjà son propre scraper ou sa propre application et doit gérer sa connexion réseau.
Ces flux se limitent-ils aux projets de chatbot ?
Non. Les exemples illustrent des capacités plutôt qu'une liste d'usages exclusive. Inventaires de sites, recherche de fournisseurs, notes sur les entreprises et découverte de documents peuvent suivre les mêmes étapes. Vérifiez que la source, l'entrée et la sortie requises sont prises en charge, puis définissez un échantillon que votre client peut évaluer.
Obtenez le premier résultat utile
Partez d'une source et d'un résultat que votre client peut vérifier.
Obtenir ma clé API gratuite